AI 엔지니어 · 8년 · 투윅스 대표

2주면,아이디어를 바로 쓸 수 있는 AI로만들어 드립니다.

기능 뒤에 있는 시스템을 만듭니다. 데이터, 모델, 검증 장치, 그리고 이를 담는 서비스까지. 첫 상담부터 운영까지 한 사람이 맡고, 2주마다 직접 써볼 수 있는 결과로 보여드립니다.

  • 100만명+제가 만든 AI의 누적 사용자
  • 7,000억원+제가 만든 AI가 돕는 연간 사업 규모
  • 36%제가 개발한 모델의 평균 성능 향상
  • 2주아이디어에서 프로토타입까지

AI를 도입하라는데, 왜 매번 제자리일까요?

  • 01

    어디서부터 시작할지 모르겠다

    AI로 뭘 할 수 있는지는 많이 듣지만, 우리 회사 업무에 어떻게 붙일지는 누구도 구체적으로 말해주지 않습니다.

  • 02

    데모는 되는데 현장에서는 안 된다

    시연 때 그럴듯했던 챗봇이 실제 고객 질문과 실제 데이터 앞에서는 엉뚱한 답을 합니다.

  • 03

    끝나면 아무것도 남지 않는 외주

    납품이 끝나면 코드도, 문서도, 운영 노하우도 외주사에만 남아 있습니다.

  • 04

    근거를 알 수 없는 견적

    왜 이 금액인지, 무엇을 빼면 얼마가 줄어드는지 설명 없는 견적서만 받습니다.

되는 것만 약속하고, 2주마다 보여드립니다.

  1. 01

    현장 데이터로 먼저 검증

    실제 문서, 통화, 데이터로 작은 버전을 먼저 만들어 보고, 효과가 확인된 기능만 본 개발로 가져갑니다.

  2. 02

    2주마다 작동하는 결과

    보고서가 아니라 직접 눌러볼 수 있는 결과물로 진행 상황을 공유합니다.

  3. 03

    기능별로 투명한 견적

    무엇에 얼마가 드는지 기능별로 보여드립니다. 필요 없는 기능은 빼고 필요한 만큼만 맡기시면 됩니다.

제가 만들어 드리는 것.

여덟 가지, 모두 실제로 납품해 본 것들입니다. 카드를 누르면 어떻게 만드는지와 어디에 적용했는지가 나옵니다.

RAG · 검색 증강 생성

사내 문서를 읽고 답하는 AI 비서

직원이 평소 말로 물으면, AI가 회사 문서를 직접 읽고 출처를 보여주며 답합니다. 답변을 바탕으로 회신 초안 작성, 양식 채우기, 티켓 열기까지 이어서 할 수 있습니다. 근거가 없으면 없다고 말합니다.

  • RAG
  • 하이브리드 검색
  • 출처 표시
  • 스트리밍 채팅
  • 카카오톡/Slack

연 매출 7,000억 원 규모 기업의 실제 서비스 앱 안에서 운영 중입니다.

어떻게 만드나닫기

받으시는 것. 문서(PDF, 워드, 엑셀, 슬라이드, 한글 오피스 형식, 스캔본)를 읽어 들이는 파이프라인, 의미와 키워드를 함께 쓰는 검색 층, 그리고 출처를 달아 답하는 채팅 화면(웹 또는 메신저 안). 접근 권한, 기억, 고객사 인프라 배포는 추가 옵션이 아니라 기본입니다.

정직하게 만드는 방법. 출시 전에 실제 질문 목록과 “일 잘하는 직원이라면 이렇게 답한다”는 기준 답변을 함께 정합니다. AI는 그 목록으로 채점되고, 이후 바뀔 때마다 다시 채점됩니다. 출처 없는 답은 답이 아니며, 시스템이 그렇게 말합니다.

기술 용어로는. 검색 증강 생성(RAG): 의미 단위 청킹, 벡터 + 키워드 하이브리드 검색과 리랭킹, 출처가 달린 답변, 스트리밍 채팅, LLM 심사 모델로 채점하는 평가 세트.

GraphRAG · 지식 그래프

전문 분야 지식을 담은 지식 그래프

작물과 처방, 부품과 고장, 규정과 사례처럼 지식이 "무엇이 무엇과 이어지는가"에 관한 것이라면, 문서 검색이 답하지 못하는 질문을 그래프가 답합니다.

  • Neo4j
  • LLM 추출
  • text-to-Cypher
  • 전문가 검수 루프

대기업 계열사에 온톨로지, 추출 파이프라인, 데이터베이스, 그 위의 에이전트까지 만들어 납품했습니다.

어떻게 만드나닫기

받으시는 것. 고객사 전문가와 함께 설계한 스키마, 문서를 그래프로 바꾸면서 품질을 관리하는 추출 파이프라인(모순은 표시하고, 사람이 결정한 사례를 기준으로 해소), 빌드·스냅샷·초기화 도구가 딸린 데이터베이스, 그리고 그래프에 자연어로 묻는 비서. 인도 후 고객사 팀이 직접 확장할 수 있도록 방법론 문서까지 드립니다.

대부분의 업체가 이걸 보여주지 못하는 이유. 어려운 부분은 데이터베이스가 아니라, 품질을 측정하면서 데이터를 만드는 일입니다. 그 구축을 실제 서비스에서 해 본 것이 제 경력입니다.

기술 용어로는. GraphRAG: 온톨로지 설계, 품질 관리가 붙은 LLM 추출, Neo4j 다중 데이터베이스, text-to-Cypher 에이전트, 그래프 + 벡터 하이브리드 검색.

AI 에이전트 · 멀티에이전트

조사하고 쓰는 AI 에이전트, 승인은 사람이

한 업무를 AI 에이전트 팀이 조사, 평가, 초안 작성까지 맡고, 밖으로 나가기 전에 사람이 승인합니다.

  • LangGraph
  • CrewAI
  • 승인 관문
  • 재개 가능한 실행
  • 에이전트별 비용

FederationLabs의 수출 바이어 보고서가 운영 중이고, STIA에는 승인 관문 2개가 있는 20개 에이전트 마케팅 파이프라인을 만들었습니다.

어떻게 만드나닫기

받으시는 것. 시장 조사, 바이어 평가, 캠페인 전략, 제안서 초안 같은 한 업무를 전문 에이전트들의 파이프라인으로 설계합니다. 검증 단계가 붙습니다: 실제 데이터에 근거 대기, 초안을 고치는 비평 에이전트, 사람이 눌러야 넘어가는 승인 관문. 결과는 느슨한 텍스트가 아니라 정형 레코드로 고객사 DB에 들어갑니다.

제가 고집하는 것. 긴 실행은 중간에 죽어도 이어서 돌아가야 합니다. 승인은 프롬프트가 아니라 코드로 강제해야 합니다. 모든 모델 호출에 비용이 붙어야 합니다. 이 세 가지가 에이전트 시스템을 1년 뒤에도 쓸 수 있게 만듭니다.

기술 용어로는. AI 에이전트와 LLM 워크플로: 메모리, 도구 사용, 가드레일, 멀티에이전트 오케스트레이션(LangGraph, CrewAI), 다단계 비즈니스 로직과 정형 출력을 위한 결정적 파이프라인, human-in-the-loop 관문, 재개 가능한 실행.

LLM 워크플로 · 문서 생성

회사 양식 그대로 완성되는 문서

녹음, PDF, 웹 데이터, 교육과정 같은 원본 자료를 회사 템플릿에 맞는 진짜 파워포인트·워드·엑셀 파일로 만듭니다. 열자마자 바로 편집할 수 있습니다.

  • PPTX/DOCX/XLSX 생성
  • OCR
  • 음성 전사
  • 스키마 검증 출력

망고팩토리에서 유료 이용 교사들에게 수업 슬라이드를, 농업 기업에는 통화 녹음으로 컨설팅 보고서를 만들어 줍니다.

어떻게 만드나닫기

받으시는 것. 지저분한 입력(스캔본, 한글 오피스 형식, 음성)을 읽는 수집 단계, 회사 템플릿을 그 자리에서 채워 브랜딩과 레이아웃이 그대로 살아남는 생성 단계, 의미로 고르는 이미지 선택, 이메일·저장소·앱 안으로의 전달. 정형 출력은 파일로 쓰기 전에 스키마로 검증해서, 잘못된 생성은 조용히 나가지 않고 크게 실패합니다.

이것이 아닌 것. 마크다운을 슬라이드에 붙여 넣은 것이 아닙니다. 팀이 원래 만들던 것과 같은 종류의 파일이 나옵니다. 더 빠를 뿐입니다.

기술 용어로는. 스키마 검증 정형 출력이 있는 LLM 워크플로, 제자리 PPTX / DOCX / XLSX 생성, 수집용 OCR과 음성 전사, 의미 기반 이미지 검색.

LLM 파인튜닝 · 모델 배포 · 음성 AI

직접 학습시켜 직접 배포하는 자체 모델

API가 너무 비싸거나, 느리거나, 부정확하거나, 데이터를 밖에 보낼 수 없을 때. 고객사 데이터로 모델을 학습시키고 고객사 장비에 배포합니다. 학습과 서빙 둘 다, 텍스트와 음성 둘 다.

  • LoRA / 전체 파인튜닝
  • vLLM / ONNX 서빙
  • 음성인식
  • 화자 분리
  • GPU + CPU 배포
  • 라벨링 도구

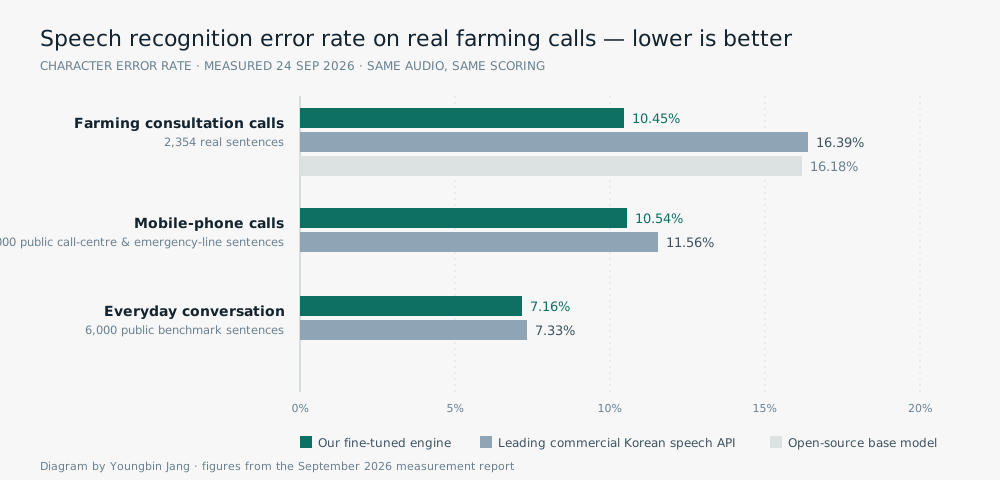
100만 명이 쓰는 서비스에서 자체 모델이 GPT-4를 대체했고, 실제 농업 통화에서 상용 API가 16.39% 틀릴 때 파인튜닝한 음성인식은 10.45% 틀립니다.

어떻게 만드나닫기

파인튜닝. 문서, 로그, 녹음에서 시작하는 데이터 파이프라인과, 필요하면 고객사 팀이 학습 데이터를 만드는 라벨링 도구. 기반 모델 선택(오픈 웨이트 LLM, 음성 모델), GPU 클러스터에서 LoRA 또는 전체 파인튜닝, 그리고 지금 쓰는 API와 고객사 테스트셋으로 비교한 평가. 바꿀지 말지가 의견이 아니라 종이 위의 숫자로 결정됩니다. API가 이기면 그렇게 말씀드립니다.

배포. 고객사 인프라에서 돌아가는 모델: vLLM 또는 ONNX Runtime, GPU 또는 CPU, 컨테이너로, OpenAI 호환 엔드포인트 뒤에. 애플리케이션은 URL만 바꾸면 됩니다. 배치와 스트리밍 모드, 수지가 맞는 곳엔 오토스케일링, 모니터링, 다음 버전도 같은 방식으로 나가는 CI/CD. 요청당 비용과 지연 시간은 전후로 측정합니다.

기술 용어로는. 성능·비용·프라이버시 제약을 위한 LLM 파인튜닝(LoRA, 전체)과 자체 모델 학습, 도메인 적응 STT·화자 분리·스트리밍 전사(GPU 클러스터), OpenAI 호환 인터페이스의 vLLM·ONNX Runtime 서빙.

LLM 평가 · 최적화 · MCP · 에이전트 하네스

AI를 측정 가능하게, 그리고 꾸준히 낫게

"잘 안 되는데 왜인지 모르겠다"를 숫자로 바꾸고, 릴리스마다 그 숫자를 올리는 평가·최적화 루프로 만듭니다. 제 모델을 세계 최고 성능까지 끌어올린 것과 같은 루프입니다.

  • 평가 하네스
  • 최적화 루프
  • LLM 심사
  • 환각 탐지
  • MCP 서버
  • 에이전트 하네스

이 루프로 만든 채점 모델이 논문으로 세계 최고 성능을 기록했고, 사실 검증 SDK 프로젝트는 별 5개 평가를 받았습니다. 제 자동 에이전트 러너는 매일 돌아갑니다.

어떻게 만드나닫기

측정. 고객과 합의한 기준, 채점된 데이터셋, 심사 모델, 버전이 붙은 리포트로 이루어진 평가 프레임워크. CI에 연결된 회귀 테스트가 있어서 모델이나 프롬프트를 바꿔도 운영 성능이 조용히 떨어질 수 없습니다. 문제가 지어낸 주장이라면, 주장 단위로 대조하는 사실 검증 컴포넌트를 붙입니다.

최적화. 그다음이 루프입니다. 실패 사례를 분석하고, 한 번에 하나만 바꾸고(프롬프트, 검색, 데이터, 파인튜닝), 다시 재고, 숫자가 움직인 것만 남기고, 안 움직인 것도 기록합니다. 성능이 운이 아니라 일정에 따라 좋아지는 방법입니다. 에세이 채점 모델을 100만 명이 쓰기 전에 세계 최고 성능으로 만든 것도 같은 루프였습니다.

무인 운영. 목표가 자율 실행이라면: 고객사 데이터와 도구 위의 MCP 서버, 권한 규칙이 있는 하네스, 잠금·타임아웃·제한된 재시도·비용 상한·실행당 한 번의 종합 알림이 있는 스케줄 러너.

뒤에 있는 규칙. 검증은 별도 프로세스에서 다른 모델로 돌립니다. 자기 일을 자기가 검토하는 시스템은 자기 실수를 놓치기 때문입니다.

기술 용어로는. 평가 하네스, LLM 심사 채점, 환각 탐지, 오류 분석 기반 최적화; 고객사 데이터와 API를 에이전트 도구로 노출하는 MCP 서버; 스케줄링·재시도·권한·human-in-the-loop를 갖춘 에이전트 하네스.

엔드투엔드 개발 · 풀스택

AI만이 아니라 제품 전체

프론트엔드, 백엔드, 데이터베이스, 배포. 아직 개발팀이 없으신가요? AI를 둘러싼 제품까지 만들고, 나중에 팀이 이어받을 수 있는 형태로 넘겨드립니다.

  • React / Next.js
  • FastAPI / NestJS
  • PostgreSQL / Supabase
  • Docker
  • AWS / GCP
  • CI/CD

망고팩토리는 혼자서 5개월 만에 처음부터 끝까지 만든 유료 SaaS이고, LG 계열사에는 작물 모니터링 대시보드와 게이트웨이를 만들었습니다.

어떻게 만드나닫기

받으시는 것. 바로 쓸 수 있는 제품: 고객이 로그인하는 앱, 그 뒤의 백엔드와 데이터베이스, 필요하면 결제와 내보내기, 고객사 클라우드 배포까지. 전체를 혼자 출시해 본 사람이 만들기 때문에, 아직 없는 팀을 AI가 기다릴 필요가 없습니다.

기술 용어로는. React, Next.js 또는 Svelte 프론트엔드; FastAPI 또는 NestJS 백엔드; PostgreSQL, Supabase 또는 Firestore; Docker, AWS 또는 GCP; 첫날부터 CI/CD와 인프라 코드화.

AX 전환 · 컨설팅

어디에 AI를 넣어야 효과가 큰지 찾기

무엇을 만들기 전에, 어떤 업무가 AI로 가장 큰 효과를 보는지 찾고, 고객사 데이터로 작은 파일럿을 돌려 확인한 뒤에 확장합니다.

  • 업무 프로세스 진단
  • 2주 파일럿
  • 효과 측정 기준
  • 로드맵

이 페이지의 모든 사례가 이렇게 시작했습니다. 2주 프로토타입 패키지가 그 파일럿입니다.

어떻게 만드나닫기

받으시는 것. 업무 흐름의 짧은 진단: 시간이 어디에 들어가는지, 어떤 데이터가 이미 있는지, 어느 단계를 AI가 측정 가능한 결과로 대신할 수 있는지. 그다음 파일럿 하나, 2주, 고객사 데이터로, 끝에는 됐는지 안 됐는지를 말해 주는 숫자. 그다음 나머지를 효과와 위험 순으로 정리한 로드맵.

이것이 아닌 것. “AI 전략” 슬라이드가 아닙니다. 결과물은 작동하는 파일럿과, 제가 아닌 어느 엔지니어에게 줘도 되는 글로 된 계획입니다.

기술 용어로는. 프로세스·데이터 감사, 후보 업무 점수화, 파일럿 전에 합의한 평가 기준, 단계별 범위와 견적이 붙은 로드맵.

첫 상담부터 운영까지, 제 일처럼 만듭니다.

  1. STEP 1

    요구사항 · 데이터 분석

    해결하려는 문제와 가지고 계신 데이터를 함께 확인합니다. 통화 녹취, 문서, DB 무엇이든 괜찮습니다.

  2. STEP 2

    범위 · 견적 문서

    기능별 소요 시간과 비용, 마일스톤을 한 문서로 정리합니다. 대표님이 읽고 바로 결정할 수 있는 문서입니다.

  3. STEP 3

    2주 단위 개발

    2주마다 직접 써볼 수 있는 결과물을 공유하고, 받은 피드백을 다음 2주에 반영합니다. 마일스톤마다 직접 해보실 수 있는 검수 기준이 글로 적혀 있고, 대금은 검수 뒤에 냅니다.

  4. STEP 4

    검증 · 인도 · 운영

    실측 수치로 성능을 검증하고, 소스코드와 문서, 운영 가이드를 모두 넘겨드립니다. 출시 후 운영도 함께합니다.

AI 상담 챗봇 구축예시 화면
M1 · 데이터 정리 · 1차 동작본완료
M2 · 현장 검증 · 정확도 개선진행 중
M3 · 앱 연동 · 운영 이관예정
다음 데모2주 차 금요일

진행 상황, 언제든 한 화면에서

  • 마일스톤 문서무엇이 언제 끝나는지 한 페이지로
  • 2주 데모말이 아니라 작동하는 화면으로
  • 프로젝트 문서 저장소기획·설계·결정 기록을 고객과 공유

꼭 필요한 기능만, 근거가 보이는 견적으로.

  1. 1

    기능별 시간 × 단가

    모든 기능을 필요한 작업 시간으로 풀어 표로 보여드립니다. 전에 만들어 본 부분은 연동에 드는 시간만 받고, 어느 줄이 그런 항목인지 견적서에 적습니다.

  2. 2

    쌓아 올리는 3단 패키지

    핵심 기능, 확장, 고도화 순서로 나눠 두어 필요한 단계까지만 고르실 수 있습니다.

  3. 3

    예산에 맞춘 범위 조정

    예산이 부족해도 품질은 낮추지 않습니다. 대신 범위를 줄이고, 나머지는 나중에 붙일 수 있게 설계합니다. 포함되지 않는 것도 견적서에 적습니다.

견적 문의하기
견적서 예시 (실제 견적은 상담 후 산정합니다)
패키지기능작업 시간
1 · 핵심문서 수집 · 정제 파이프라인24h
1 · 핵심근거가 달린 답변 챗봇40h
2 · 확장관리자 화면 · 답변 품질 대시보드32h
3 · 고도화카카오톡 · 앱 연동24h
추천

2주 프로토타입 패키지

아이디어가 실제로 되는지, 보유하신 데이터로 2주 안에 확인합니다. 큰 비용을 들이기 전에 방향이 맞는지 먼저 확인할 수 있습니다.

  1. DAY 1–3

    요구사항 · 데이터 수집

    목표와 성공 기준을 정하고 필요한 데이터를 모읍니다.

  2. DAY 4–7

    1차 동작본

    핵심 기능 하나를 실제로 작동하게 만듭니다.

  3. DAY 8–11

    현장 데이터로 검증

    실제 데이터로 돌려 보고, 수치로 확인하며 고칩니다.

  4. DAY 12–14

    리뷰 · 다음 범위 확정

    결과를 함께 보고 본 개발 범위와 견적을 정합니다.

2주 뒤 손에 남는 것
  • 직접 써볼 수 있는 프로토타입
  • 수치로 정리한 검증 리포트
  • 본 개발 범위 · 견적 문서
패키지 문의하기

어떤 프로젝트를 했고, 무엇이 달라졌는지.

사례 8건, 고객사 이름은 허락을 받고 씁니다. 카드를 누르면 기술적인 내용까지 전체 이야기가 나옵니다.

  • 100만명+제가 만든 AI의 누적 사용자

    영어 시험 연습 서비스 TestGlider. 에세이·말하기 채점 모델을 제가 만들고 운영했습니다.

  • 7,000억원+제가 만든 AI가 돕는 연간 사업 규모

    LG 계열 팜한농. 제가 만든 AI 재배 상담이 앱 안에서 돌아가고 있고, 2026년 5월부터 전체 농가로 넓히고 있습니다.

  • 36%제가 개발한 모델의 평균 성능 향상

    예를 들어 농업 현장 통화에서 100글자 중 16개를 틀리던 상용 음성인식을, 제 모델은 10개로 줄였습니다.

  • 2주아이디어에서 프로토타입까지

    보유하신 데이터로 돌아가는 첫 버전을 2주 안에 직접 써보실 수 있습니다.

  • 5개월기획부터 상용 출시까지

    망고팩토리. 선생님들이 돈을 내고 쓰는 SaaS를 첫 줄부터 출시까지 혼자 만들었습니다.

  • 60억원+제 기술로 고객사가 유치한 투자

    TestGlider가 제 채점 모델을 핵심 기술로 투자를 유치했습니다. 이 모델은 논문으로 세계 최고 성능을 입증했습니다.
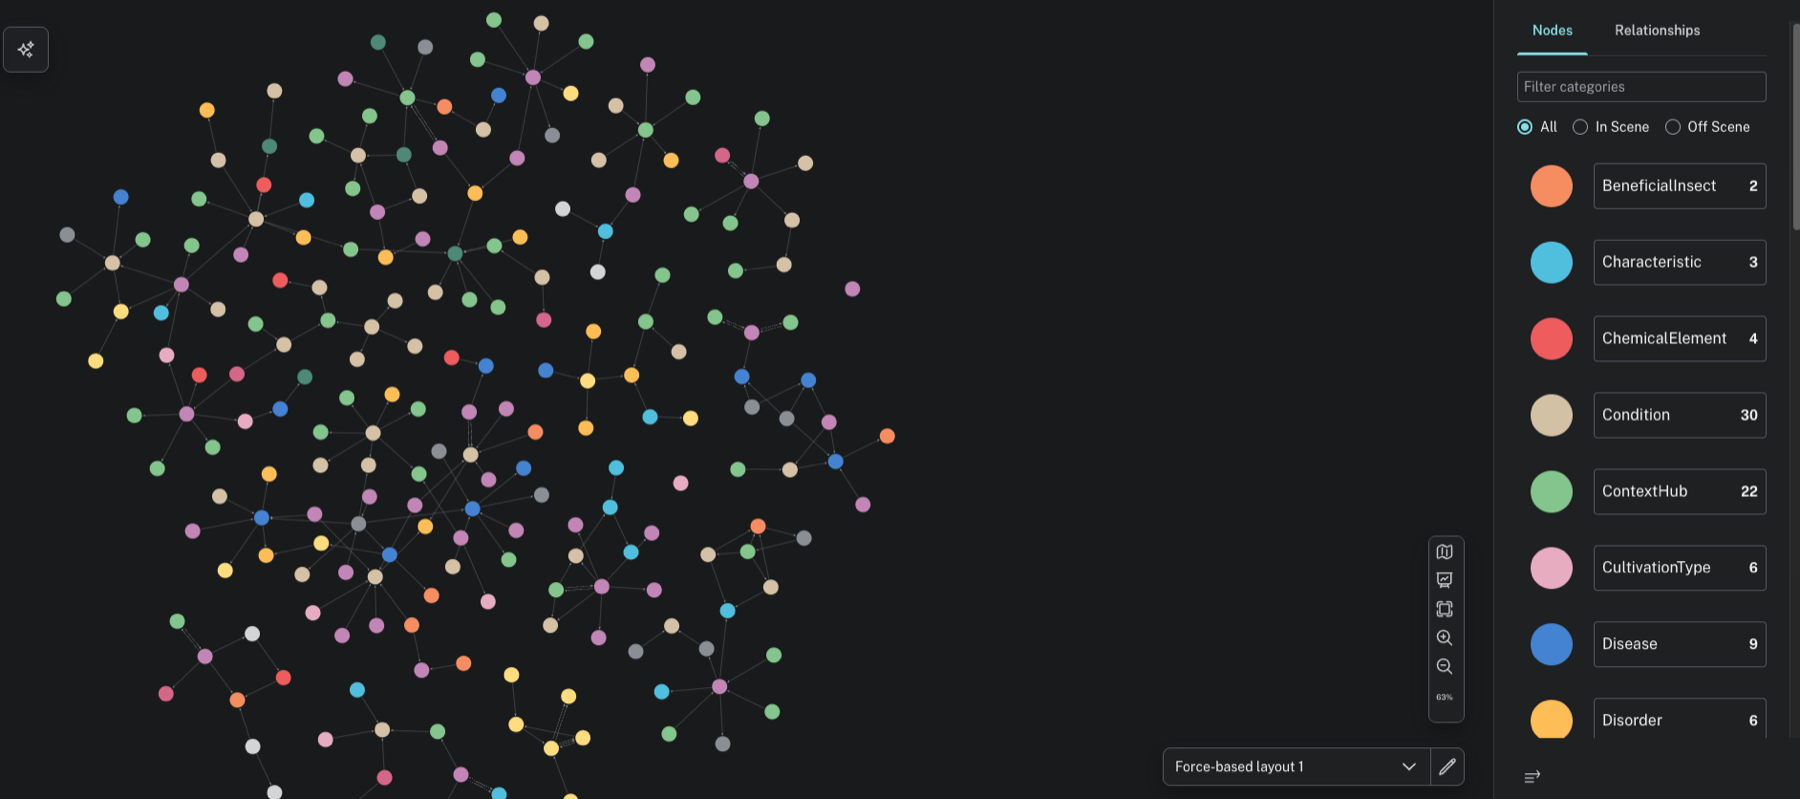
Neo4j에 구축된 농업 지식 그래프. 환경 조건, 병해, 재배 유형 등이 색깔별 노드로 연결되어 있다

팜한농 (FarmsAll)LG 계열 · 농업 · 연 매출 7,000억 원+2025–2026

농업 기업 앱 안에서 운영 중인 AI 재배 상담

문제
전문가 지침, 과거 보고서, 컨설턴트 통화가 흩어져 있어 농민이 물을 때 꺼내 볼 수 없었습니다.
만든 것
회사 노하우의 지식 그래프, 출처를 달아 답하는 상담 AI, 통화로 컨설팅 보고서 초안을 쓰는 코파일럿.
  • 실제 서비스에서 운영 중 · 2026년 5월부터 전체 농가로 확대
  • 답변은 출처를, 보고서는 통화 원문을 인용
  • 아키텍처 지도 하나, 게이트웨이 하나로 저장소 16개를 정렬
사례 자세히 보기닫기

AI가 쓰는 모든 문장은 어디서 왔는지를 가리킵니다. 가리킬 수 없으면 그 문장은 지워집니다.

  • 고객사대기업 계열사, 연 매출 7,000억 원 이상
  • 상태실제 서비스 앱에서 운영 중
  • 범위지식 그래프 · 상담 AI · 보고서 코파일럿 · 대시보드
  • 코드베이스저장소 16개, 핵심 2개에 커밋 약 1,000건

필요했던 것

대형 농업 기업이 농가 대상 컨설팅 서비스를 운영합니다. 가장 좋은 지식은 전문가 지침, 수년치 컨설팅 보고서, 컨설턴트의 통화 안에 있었습니다. 그런데 농민이나 신입 컨설턴트가 필요한 순간에는 그 어느 것도 꺼내 볼 수 없었습니다. 상담 한 건을 보고서로 쓰는 데 방문만큼의 시간이 들었습니다.

만든 것

두뇌 하나를 공유하는 세 가지. 회사 문서로 만들고 회사 전문가가 품질을 관리한 농업 기술 지식 그래프. 출처를 달아 답하고, 근거가 없으면 답하지 않는 앱(웹·카카오톡) 안의 상담 AI. 녹음된 상담을 주제별 보고서로 바꿔 PDF로 내보내는 보고서 코파일럿. 모든 항목이 통화의 어느 문장에서 왔는지를 가리킵니다.

달라진 것

상담 AI와 보고서 코파일럿이 실제 서비스 앱 안에서 돌아갑니다. 2026년 5월부터 전체 농가로 넓히고 있습니다. 결과물만이 아니라 방법을 넘겼기 때문에, 고객사 팀이 인도 후에도 그래프를 직접 확장할 수 있습니다.
기술적으로는
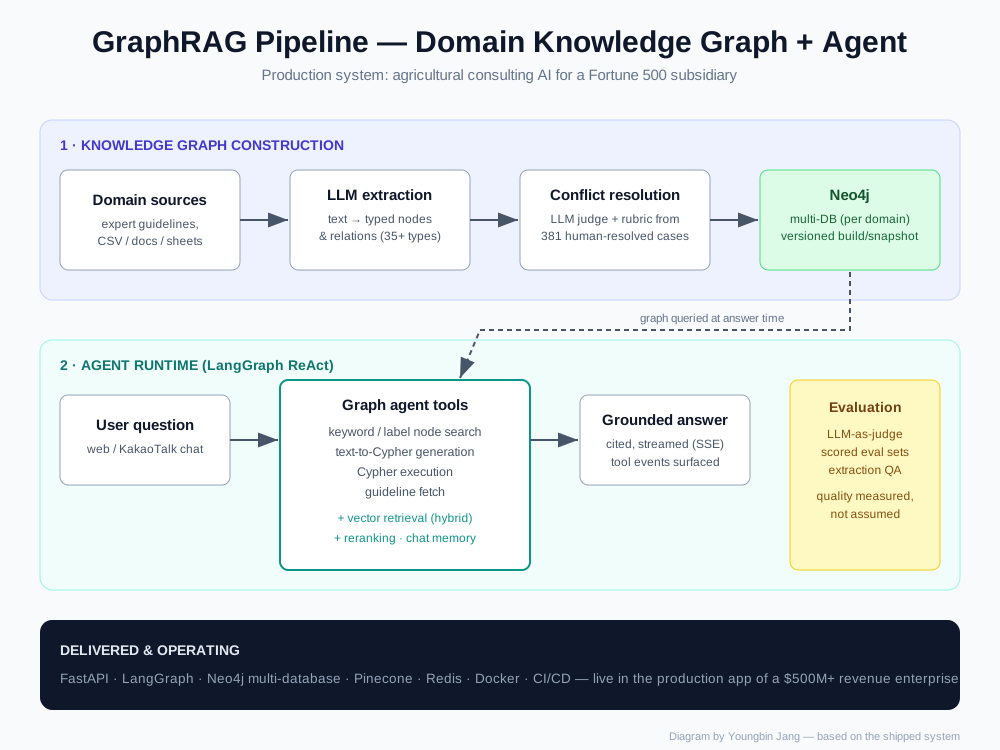
  • Neo4j 지식 그래프, 노드 유형 35개 이상, 도메인별 다중 데이터베이스. 유형별 few-shot 예시를 라우팅하는 text-to-Cypher. 실행은 코드 수준에서 읽기 전용(쓰기 차단, 30행 제한).
  • 모순 해소가 붙은 LLM 추출: 사람이 해소한 사례 381건으로 보정. LLM 심사 평가 루프, 결정적 병합과 중복 제거.
  • LangGraph 보고서 파이프라인: 전사 → 사실 추출 → 주제 선택 → 주제별 서브그래프(참조 조회 → 사실 매핑 → 결정적 매퍼가 모호하다고 표시할 때만 명확화 → 작성 → 렌더 → 검증). 모든 항목의 근거 목록을 전사 턴 번호로 검증하고, 근거가 남지 않은 항목은 삭제. 별도 검증 단계는 강등만 가능: 등급을 내릴 수는 있어도 올릴 수는 없음.
  • 문서 인텔리전스: PDF, DOCX, XLSX, PPTX, CSV를 인코딩 폴백과 함께 읽는 로더 하나, 그리고 처음부터 작성한 HWPX(한글 오피스 형식) 파서.
  • 측정한 뒤 끔: LLM 용어 교정 단계를 실제 통화 84건으로 다시 재고 비활성 상태로 출시. 카탈로그 85행과 규칙 하나면 충분했음. 전체를 관통하는 패턴은 LLM이 제안하고, 코드가 적용하고 지킨다.
  • 운영: GPU 영역을 부르는 곳은 게이트웨이 하나뿐(OpenAI 호환 인터페이스라 Gemini, OpenAI, 자체 모델을 URL만 바꿔 교체). nginx + TLS. 운영 환경 LangSmith 트레이싱. 코딩 에이전트가 코드를 만지기 전에 지도를 읽도록 저장소마다 아키텍처 노트.
Neo4j에 렌더링된 지식 그래프
지식 그래프 그 자체. 환경 조건, 병해, 생리장해, 재배 유형, 천적 곤충이 AI가 검색하는 형태로 연결되어 있습니다
GraphRAG 파이프라인 다이어그램
지식이 그래프가 되는 과정과, AI가 그래프를 쓰는 방법
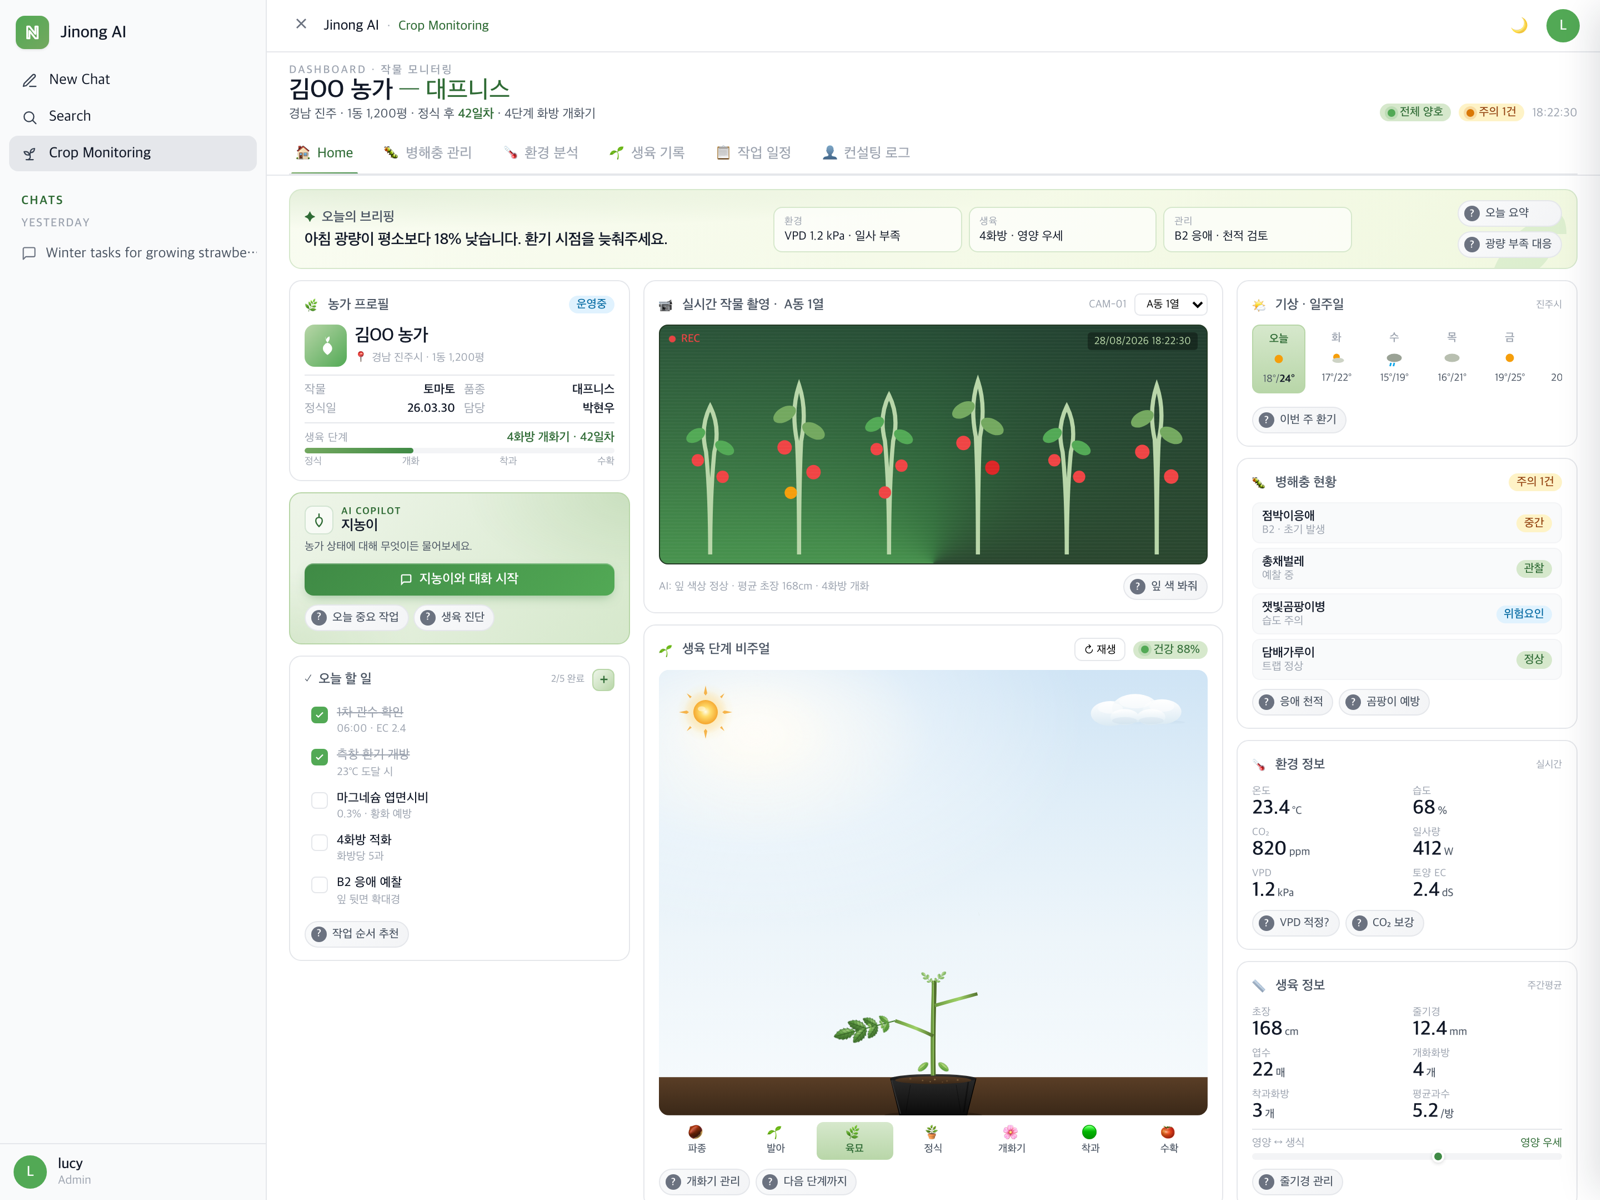
작물 모니터링 대시보드
상담 AI와 함께 납품한 작물 모니터링 대시보드
  • LangGraph
  • Neo4j
  • FastAPI
  • React
  • Gemini
  • vLLM
  • Chroma
  • Redis
  • Docker
세 종류 음성에 대한 글자 오류율 막대그래프. 우리 엔진, 상용 API, 오픈소스 기본 모델 비교

팜한농 (FarmsAll)LG 계열 · 농업2025–2026

실제 농업 통화에서 상용 API를 이기는 음성인식

문제
범용 음성인식이 전화 통화의 작물명·농약명·상표명을 엉망으로 받아 적어 아무도 전사를 믿지 않았습니다.
만든 것
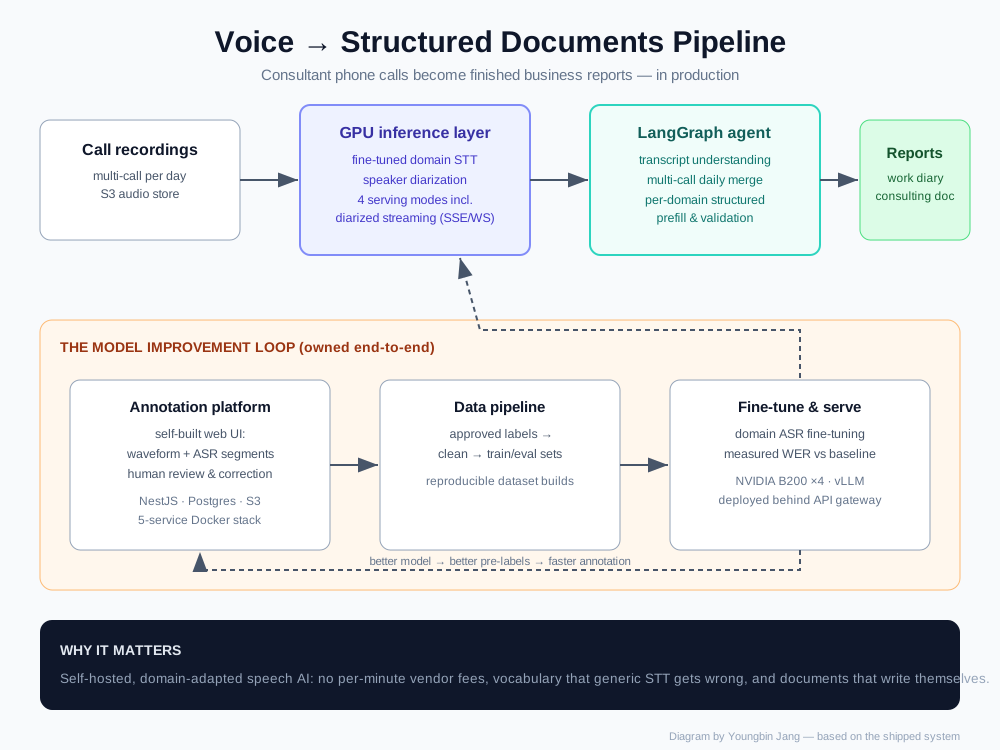
농업 통화로 파인튜닝한 음성 모델, 56,000개 용어 사전, 검수 플랫폼, 모든 시스템이 부르는 게이트웨이.
  • 실제 농업 통화 오류 10.45%, 국내 1위 상용 API는 16.39%
  • 선별한 음성 약 1,300시간 + 고객사 통화 7시간으로 16.18%(오픈소스 기본)에서 10.45%로
  • 자체 서버 B200 4장 · 서빙 모드 4가지 · 라벨링 플랫폼 매일 사용 중
사례 자세히 보기닫기

고객사 통화의 1%로 학습했습니다. 나머지 99%가 로드맵입니다.

  • 농업 통화10.45% CER · 상용 API 16.39% · 기본 모델 16.18%
  • 일상 대화7.16% · 상용 API 7.33%. 잃은 것 없음
  • 학습 데이터검토한 약 14,000시간 중 약 1,300시간 선별, + 고객사 통화 471건
  • 서빙B200 4장, vLLM, 배치 / 스트리밍 / 화자 분리

필요했던 것

컨설턴트는 하루 종일 농민과 전화합니다. 그 통화에 영농일지와 상담 보고서에 들어가야 할 사실이 있습니다. 그런데 범용 음성인식은 작물명, 농약명, 상표명, 지역 용어를 엉망으로 받아 적었고, 사용자는 전사 결과를 믿지 않게 됐습니다. 기성 엔진은 뉴스와 스튜디오 대화에서 점수를 잘 받도록 학습되어 있습니다. 휴대전화로 하는 농업 통화에 맞춰 최적화하는 곳은 없습니다.

만든 것

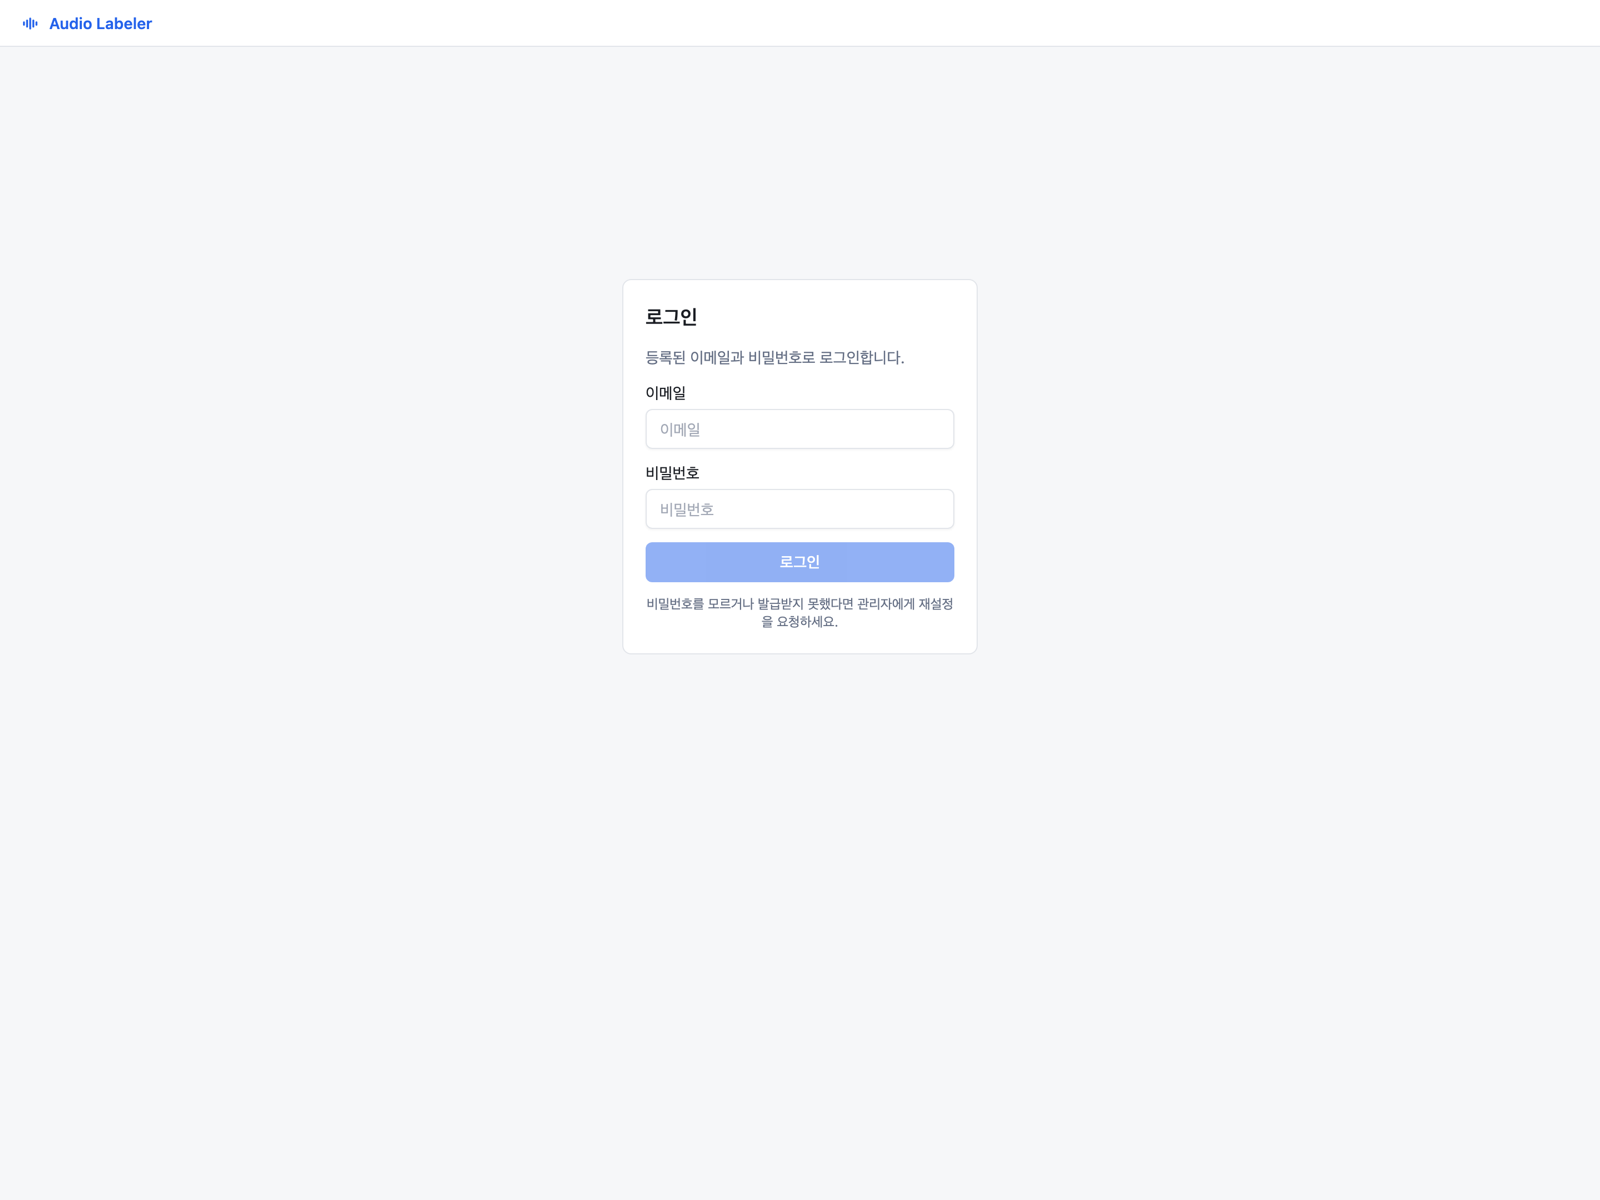
네 부분입니다. 팀이 전사를 고치고 학습 데이터를 만드는 사람 검수 플랫폼. 회사 GPU에서 서빙되는, 화자 분리가 붙은 파인튜닝 음성 모델. 인식된 용어를 엔진에 힌트로 되돌려 주는 56,000개 농업 용어 사전. 그리고 다른 모든 시스템이 부르는 게이트웨이: 배치 또는 스트리밍, 화자 라벨 유무 선택. 그 뒤에서 전사 결과가 보고서 코파일럿으로 흘러갑니다.

달라진 것

고객사의 실제 통화 2,354문장으로, 모든 엔진에 같은 채점 규칙을 적용해 측정했습니다. 우리 엔진: 글자 오류율 10.45%. 국내 1위 상용 음성 API: 16.39%. 출발점이었던 오픈소스 모델: 16.18%. 일상 대화에서는 상용 API와 같은 수준(7.16% 대 7.33%)이고, 공개 휴대전화 녹음에서는 앞섭니다(10.54% 대 11.56%). 업계에서 흔히 말하는 기준으로 20% 언저리는 “쓸 수 있지만 다시 확인”, 10% 언저리는 “믿을 수 있음”입니다. 고객사는 녹음된 통화의 약 1%만 라벨링하고 첫 번째 구간에서 두 번째 구간으로 옮겨 갔습니다.
기술적으로는
  • 데이터: 공개 한국어 음성 코퍼스 8종(약 14,000시간)을 검토, 약 11,000시간을 라이선스·정제, 약 1,300시간(약 91만 문장)을 학습에 사용. 전화 채널 녹음 비중을 35%로 올렸는데, 양이 아니라 이 비율이 숫자를 움직였음. 전화 녹음은 채널 지문으로 검증. 여기에 고객사 통화 471건(약 9시간): 약 7시간은 학습, 93건(약 2시간)은 고정 심사 세트로 따로 보관.
  • 합격 기준: 모든 후보 엔진을 같은 고객사 통화 심사 세트로 판정. 일상 대화 성능은 0.3점 이상 떨어지면 안 됨.
  • 확장 근거: 같은 학습량에서 고객사 통화를 99건에서 347건으로 늘리자 오류가 12.7%에서 11.3%로. 두 배마다 약 0.7점. 아직 라벨링하지 않은 고객사 통화가 약 1,000시간. 전부 쓰면 약 7%, 용어 사전과 후처리까지 하면 5%로 예상.
  • 모델과 서빙: B200 4장에서 Qwen3-ASR 파인튜닝과 pyannote 화자 분리, OpenAI 호환 /v1/audio/transcriptions 인터페이스 뒤에서 vLLM으로 서빙. 모드: 배치, 스트리밍, 화자 분리, 화자 분리 스트리밍.
  • 검수 플랫폼: TypeScript 모노레포(NestJS, Postgres, S3), 커밋 771건. API, 워커, 웹 앱이 공유하는 텍스트 교정 패키지.
  • 측정 위생: 모든 엔진에 같은 정규화(문장 부호 제거, 숫자 표기 통일, 띄어쓰기 무시). 심사 세트의 띄어쓰기 불일치만으로 1.7점이 왔다 갔다 했기 때문에, 대량 라벨링 전에 전사 지침을 먼저 고정. 2,354발화로 측정한 후처리 엔진은 아무것도 더하지 않았고, 그렇게 기록.
  • 정리: 체크포인트 정리로 GPU 스토리지 9.7 TiB 회수.
세 종류 음성의 글자 오류율. 우리 엔진, 상용 API, 오픈소스 기본 모델
2026년 9월 24일 측정, 학습에 쓰지 않은 음성, 모든 엔진에 같은 정규화 적용
녹음에서 보고서까지의 음성 파이프라인 다이어그램
녹음에서 보고서까지의 파이프라인
음성 라벨링 플랫폼
학습 데이터를 만드는 사람 검수 플랫폼
  • Qwen3-ASR
  • pyannote
  • vLLM
  • FastAPI
  • NestJS
  • PostgreSQL
  • S3
TestGlider 서비스 화면

TestGlider (데이터뱅크)에듀테크 스타트업 · 사용자 약 100만 명2020–2023

100만 학습자의 에세이와 말하기 채점

문제
에세이와 말하기 답변에 즉각적이고 일관된 점수가 필요했지만, 사람 채점도 호출당 과금 API도 규모를 감당하지 못했습니다.
만든 것
자체 에세이·말하기·첨삭 모델과 자체 호스팅 음성인식을 AWS 운영 서비스 4개로.
  • 사용자 약 100만 명 · 60억 원+ 투자 유치를 뒷받침
  • 자체 모델이 LLM 첨삭 파이프라인을 대체
  • 자체 호스팅 음성인식이 호출당 과금하던 외부 비용을 대체
사례 자세히 보기닫기

자체 모델은 API를 따라잡은 것이 아닙니다. 운영 환경에서 API를 대체했습니다.

  • 사용자약 100만 명
  • 뒷받침한 투자60억 원+ ($5M+)
  • 운영 서비스4개, 스테이징·운영 CI/CD 분리
  • 연구arXiv 2309.02740. 발표 당시 세계 최고 성능

필요했던 것

TOEFL·IELTS 학습자는 자기 에세이나 말하기 답변이 몇 점일지 지금 당장 알고 싶어 합니다. 사람 채점은 규모가 안 나오고, 답변마다 외부 서비스에 돈을 내는 것도 마찬가지입니다. 점수는 견고해야 했습니다. 엉터리 답변은 0점이어야 하고, 사용자가 보는 점수는 모델이 낸 점수와 같아야 합니다.

만든 것

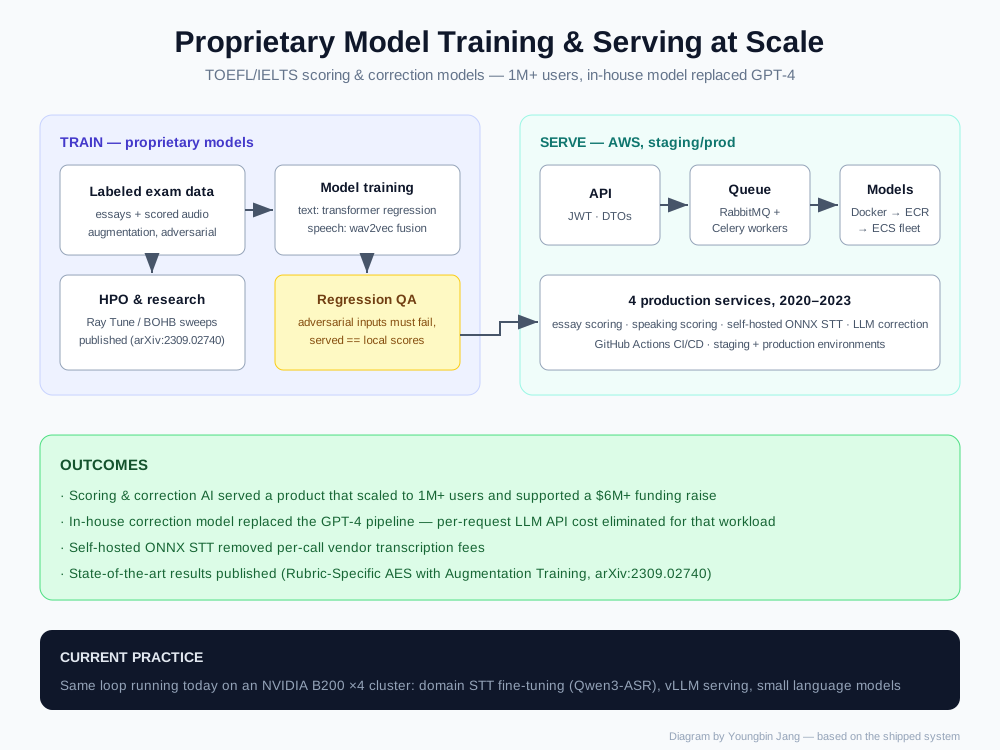
회사의 자체 에세이 채점 모델(그 뒤의 연구는 발표 당시 세계 최고 성능)과, 음성을 듣고 전사를 읽는 말하기 채점 모델. 나중에는 GPT-4 파이프라인을 대체한 자체 첨삭 모델과, 외부 비용을 대체한 자체 호스팅 음성인식 서비스. 네 가지 모두 AWS에서 운영 서비스로 돌아갔고, 배포마다 실제 모델을 검사하는 테스트 하네스가 있었습니다.

달라진 것

회사가 소유한 모델 위에서 서비스가 약 100만 명 규모로 성장했고, AI는 60억 원 이상 투자 유치의 핵심이었습니다.
기술적으로는
  • 에세이 채점: 루브릭별 헤드가 있는 트랜스포머 회귀, 적대적 학습과 증강(arXiv:2309.02740). 말하기: wav2vec 음성 특징과 텍스트를 결합.
  • 서빙: Flask/uwsgi + Celery·RabbitMQ 워커, Docker → ECR → ECS, 스테이징과 운영 파이프라인 분리. 음성인식은 비용 때문에 ONNX Runtime으로 이식.
  • 하네스: 배포 시 실제 모델 검사. 엉터리 답변은 0점이어야 하고, 서빙 점수는 로컬 추론과 일치해야 함.
  • 부수 작업: 같은 제품군을 위한 TypeScript RAG 애플리케이션(NestJS, 벡터 + 키워드 하이브리드 검색, React).
모델 서빙 아키텍처
모델을 학습하고, 실제 트래픽으로 검증하고, 서빙하는 방법
  • PyTorch
  • HuggingFace
  • wav2vec
  • ONNX Runtime
  • Flask
  • Celery
  • RabbitMQ
  • Docker
  • AWS ECS
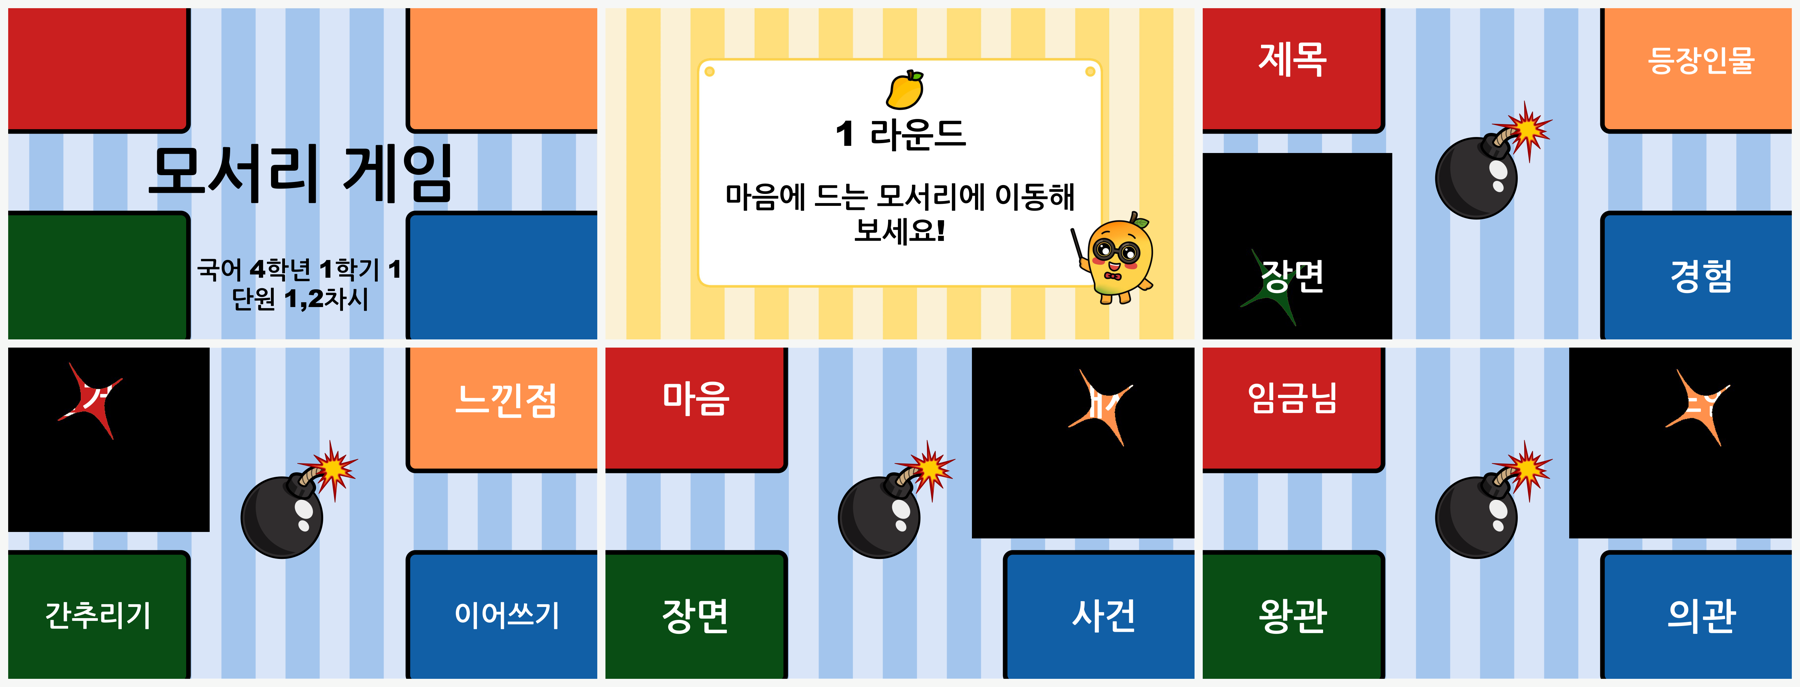
학교 템플릿으로 생성된 교실 보드게임 슬라이드 6장

망고팩토리 (MangoFactory)에듀테크 SaaS · 유료 이용 교사2025

학교 양식 그대로 나오는 수업 슬라이드

문제
교사들이 매일 저녁 수업 슬라이드·활동지·퀴즈를 학교 양식에 맞춰 손으로 다시 만들었습니다.
만든 것
제품 전체: 학교 파워포인트를 그 자리에서 채우는 엔진, 120GB+ 교육과정 검색, 앱과 관리자 콘솔.
  • 유료 사용자 · 현직 교사가 실제 수업에서 사용
  • 2025년 7월–11월, 5개월 만에 혼자 구축
  • 고객사 PPTX 템플릿을 그대로 채움. 이미지로 굽는 부분 없음
사례 자세히 보기닫기

슬라이드 그림이 아닙니다. 교사가 열어서 고칠 수 있는 진짜 슬라이드입니다.

  • 자료120GB+ 교육과정, 검색 증강
  • 출력PPTX · DOCX · XLSX · 퀴즈
  • 검증한 슬라이드59장, 11가지 레이아웃, 전부 편집 가능
  • 팀1명, 커밋 약 230건

필요했던 것

초등 교사들은 저녁 시간을 수업 슬라이드, 활동지, 퀴즈 만드는 데 씁니다. 고객사는 수업을 짧게 설명하면 그 파일들이 학교 디자인 그대로, 편집 가능하게, 교육과정에 맞춰 나오는 제품을 원했습니다.

만든 것

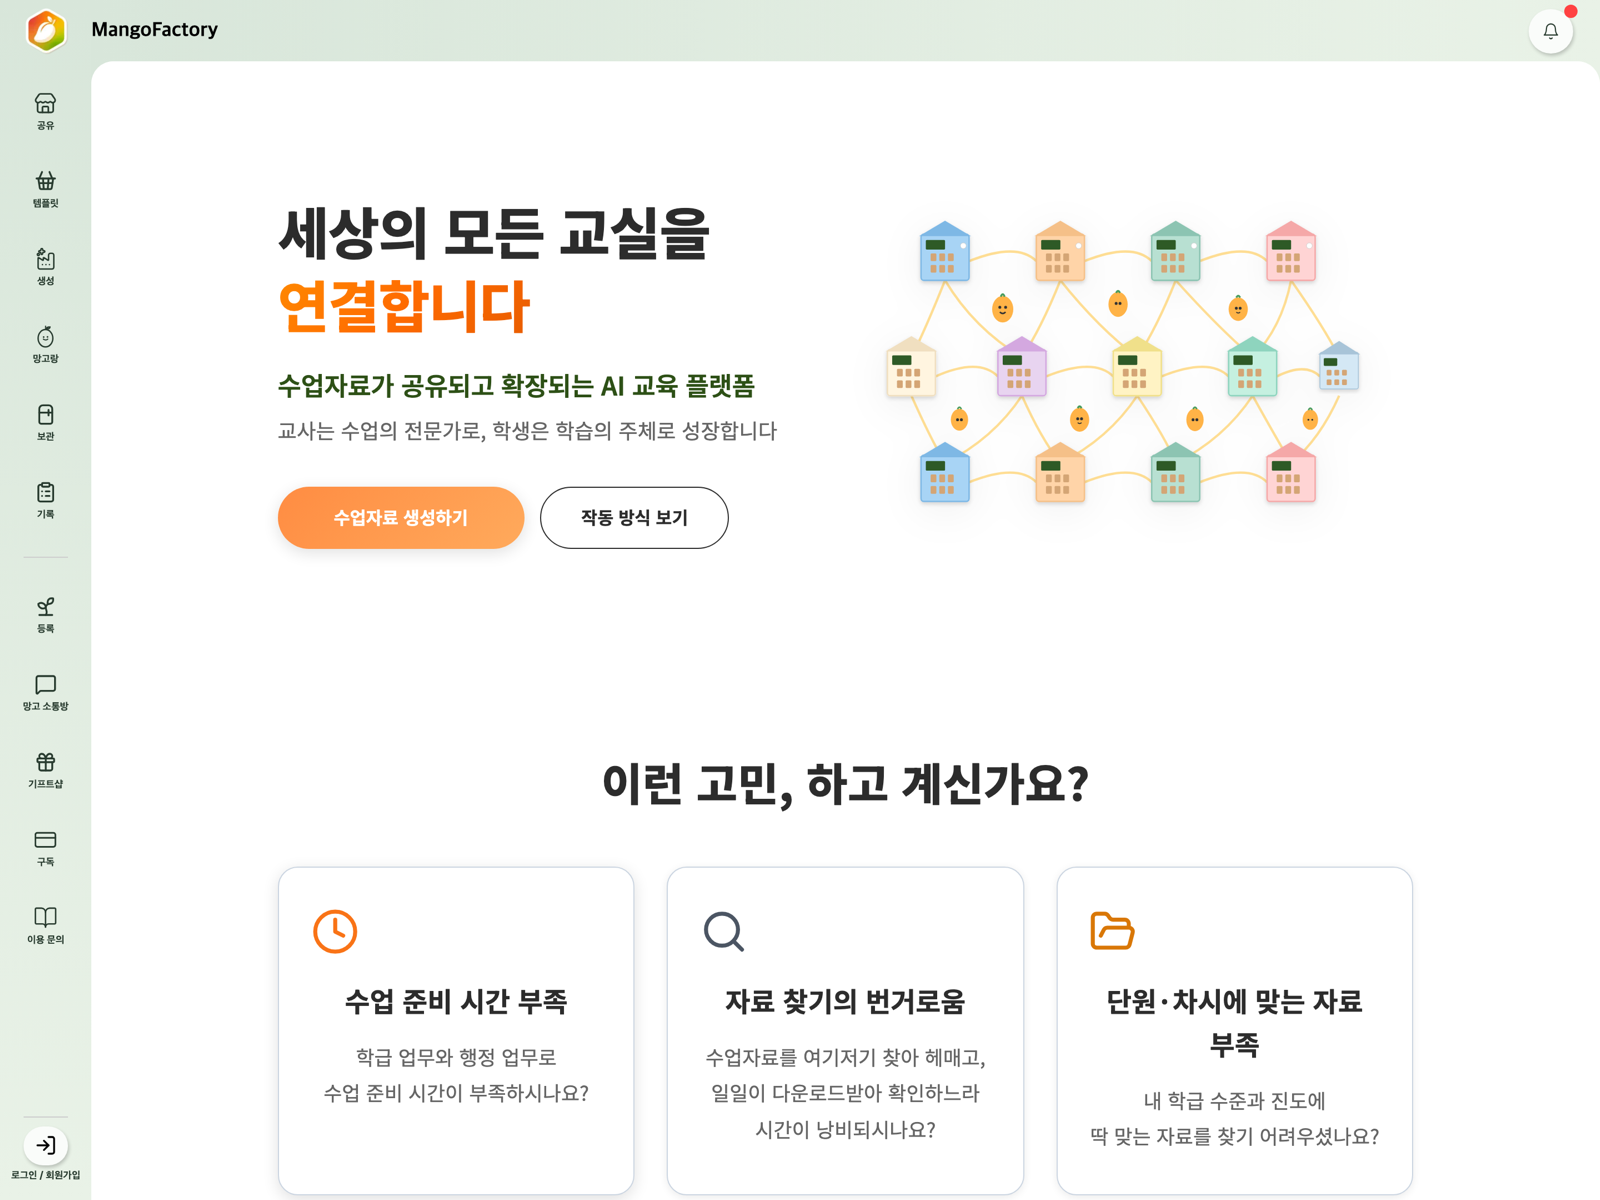
제품 전체: 교사용 앱, 관리자 콘솔, 백엔드, 생성 에이전트. 핵심은 고객사의 파워포인트 템플릿을 그 자리에서 채우는 템플릿 엔진입니다. 브랜딩은 템플릿 그 자체이고 모든 글상자는 편집 가능한 채로 남습니다. 120GB가 넘는 자료 위의 검색 층이 내용의 근거가 되고, 이미지는 키워드가 아니라 의미로 고릅니다.

달라진 것

교사들이 돈을 내고 쓰며, 결과물을 수업에서 씁니다. 슬라이드 길이는 수업 시간을 따라가고, 템플릿은 손상 없이 살아남습니다.
기술적으로는
  • 제자리 PPTX 채우기(python-pptx): 기존 텍스트 프레임, 런, 표 셀을 다시 쓰고 런·문단·프레임 스타일을 앞으로 복사. 슬라이드 마스터, 레이아웃, 테마는 원본에서 상속.
  • 레이아웃 충실도: 그룹 도형과 표를 가로지르는 안정적인 도형 주소, 기하 정보 저장·복원, 단어 줄바꿈 시뮬레이션이 붙은 이진 탐색 글꼴 자동 맞춤으로 텍스트가 원래 상자에 맞게.
  • 제한된 생성: LLM 출력을 Pydantic 스키마(slide, shape, content)에 묶고, 결정적 폴백 매핑을 둠.
  • LangGraph 슬라이드 파이프라인: 수업 시간으로 목표 길이를 계산하고, 살릴 템플릿 슬라이드를 고르고 순서를 정하며, 원래 자리표시자 위치에 의미 벡터 검색(Pinecone + 임베딩)으로 이미지를 교체.
  • 수집: OCR과 이미지 자동 태깅. 같은 코드베이스에 DOCX/XLSX/CSV/PDF 생성기.
  • 스택: Lovable/React 앱, Supabase + FastAPI 백엔드, S3, Redis, EC2/Vercel.
생성된 29장짜리 교실 보드게임 슬라이드 중 6장
생성된 한 벌 29장 중 6장. 초등 4학년 국어 수업용 교실 보드게임을 학교 템플릿에 채운 것 (모든 글상자 편집 가능)
망고팩토리 앱. 교사가 쓰는 화면
교사가 쓰는 앱. 수업을 설명하면 파일을 받습니다
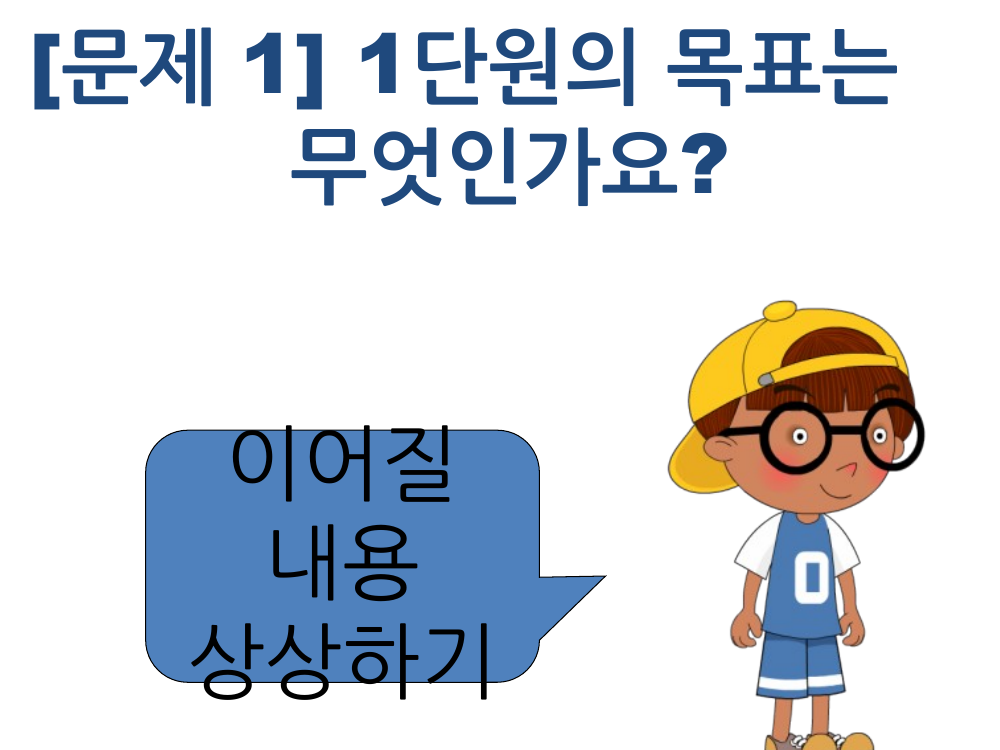
생성된 퀴즈 슬라이드
다른 슬라이드 묶음에서 나온 퀴즈 슬라이드
  • LangGraph
  • python-pptx
  • Pinecone
  • FastAPI
  • Supabase
  • React
  • Lovable
  • S3
  • Redis
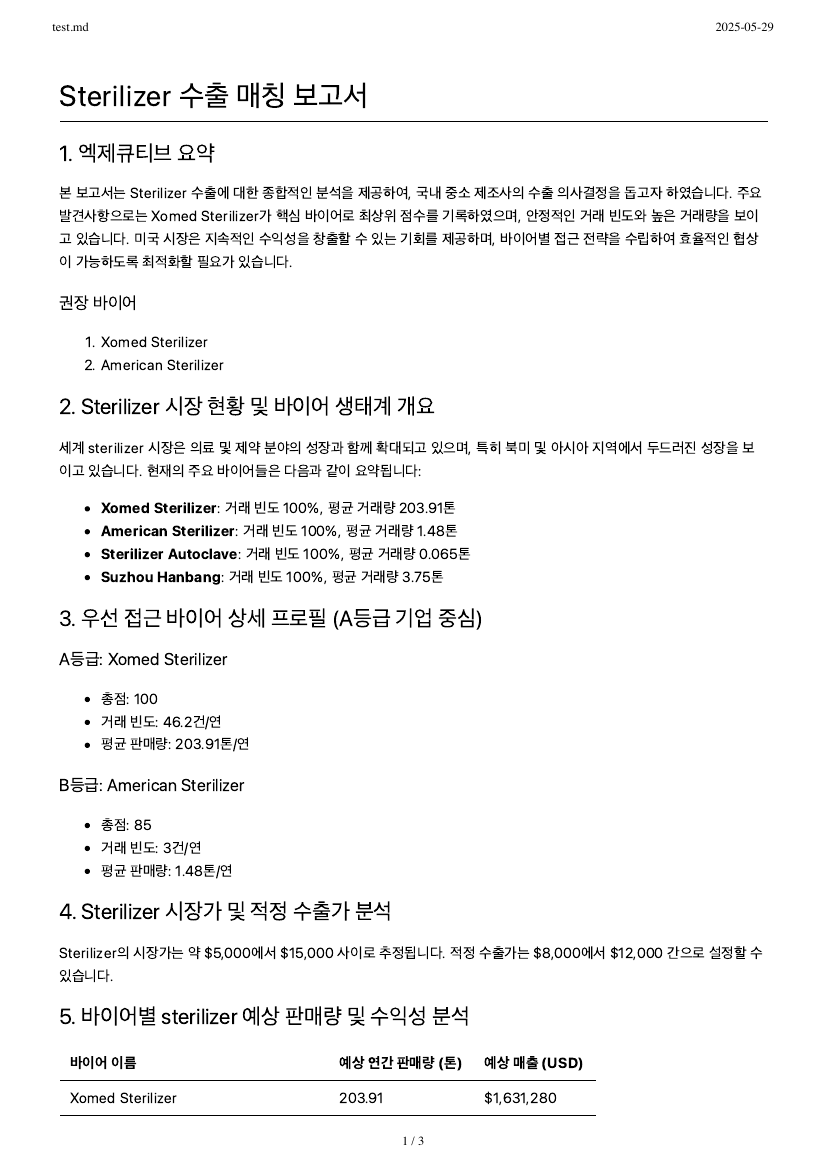
생성된 바이어 조사 보고서 첫 페이지

FederationLabs무역 정보 스타트업2025

AI 에이전트 팀이 쓰는 수출 바이어 조사 보고서

문제
해외 바이어를 찾고 검증하는 데 분석가가 제품당 며칠을 썼습니다.
만든 것
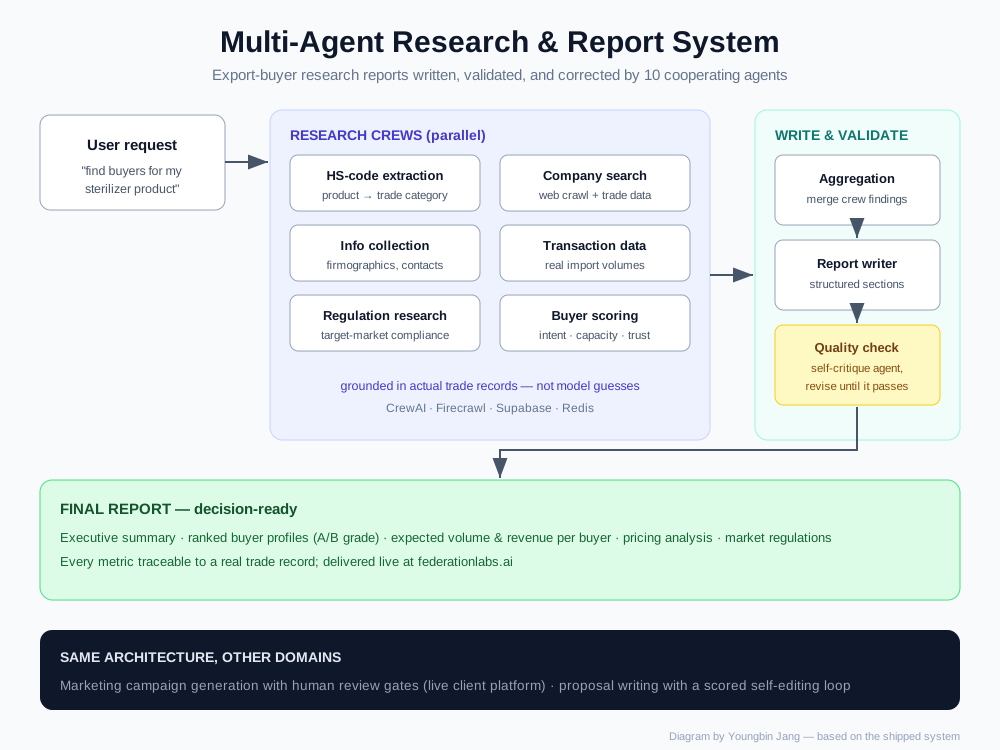
품목 분류, 회사 검색, 무역 기록 조회, 규제 확인, 바이어 평가, 보고서 작성을 나눠 맡는 에이전트 크루 8개.
  • 2025년 3월–6월 납품, federationlabs.ai에서 운영 중
  • 실제 무역 기록으로 바이어를 A/B 등급으로 평가
  • 보고서가 나가기 전에 자체 비평 단계가 고쳐 씀
사례 자세히 보기닫기

보고서는 바이어마다 등급을 매기고, 등급에는 이유가 붙어 있습니다.

  • 에이전트크루 8개, 에이전트 10개
  • 조사Brave 검색 + Firecrawl
  • 납품아이디어 → 운영, 4개월
  • 출력정형 보고서 + 보고서 위의 채팅

필요했던 것

제품에 맞는 해외 바이어를 찾는 데 분석가가 제품당 며칠을 썼습니다. 품목을 분류하고, 회사를 검색하고, 무역 데이터를 뽑고, 규제를 확인하고, 순위를 매기고, 씁니다. 고객사는 그것을 제품으로 만들고 싶어 했습니다.

만든 것

크루 8개로 이루어진 멀티에이전트 파이프라인. 하나는 무역 분류를 뽑고, 하나는 회사를 검색하고, 하나는 무역 기록을 가져오고, 하나는 규제를 조사합니다. 하나는 바이어를 점수화하고, 하나는 쓰고, 하나는 품질을 검사해 고쳐 쓰고, 하나는 완성된 보고서 위에서 사용자와 대화합니다. 등급은 실제 무역 기록에 근거하고, 작성자는 자기 비평가를 통과해야 합니다.

달라진 것

서비스가 아이디어에서 배포된 제품까지 4개월 만에 갔고, 지금도 운영 중입니다.
기술적으로는
  • 타입이 있는 핸드오프를 쓰는 CrewAI 크루. 웹 조사는 Brave 검색과 Firecrawl(관리형 스크래퍼만 사용, 헤드리스 브라우저 없음).
  • 무역 기록에서 나오는 점수화. A/B 바이어 등급과 그 근거를 함께 보존.
  • 품질 루프: 보고서를 저장하기 전 자체 비평·수정 단계.
  • 플랫폼: FastAPI, Supabase, Redis. 보고서를 저장하고 채팅 인터페이스와 함께 제공.
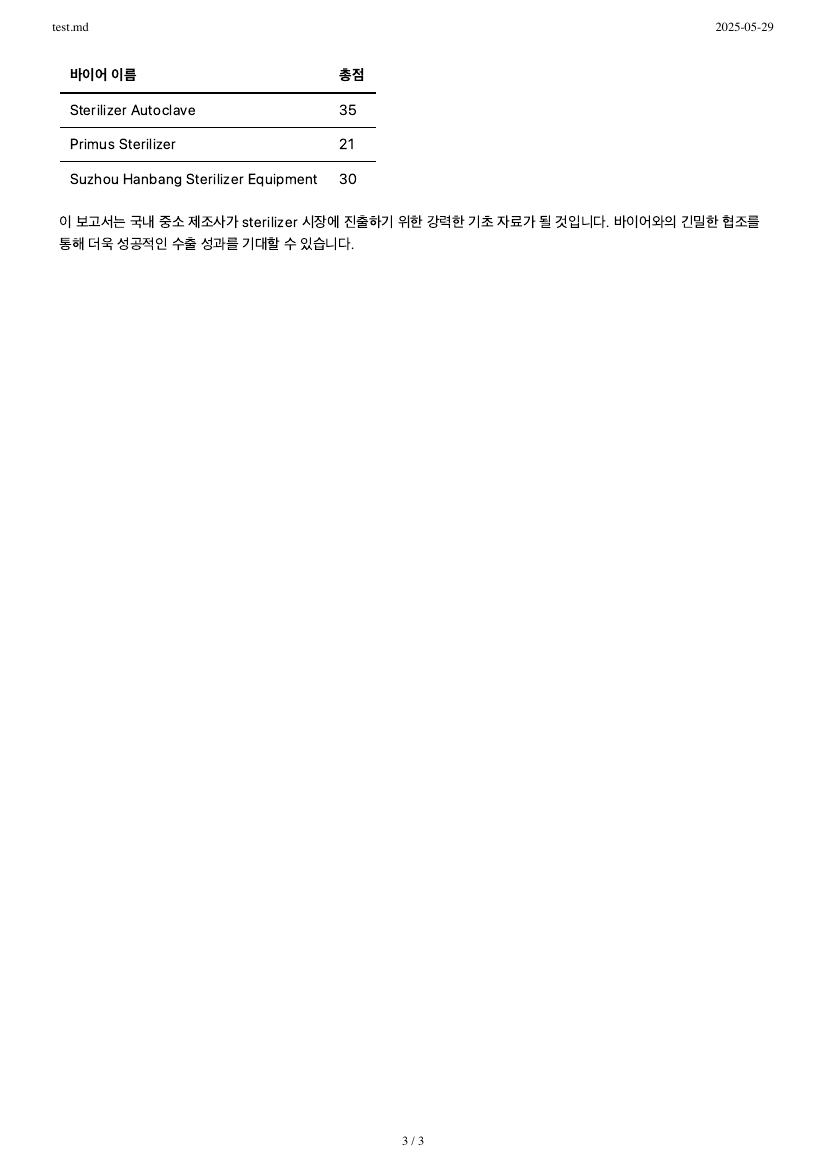
보고서 2페이지
등급이 매겨진 바이어 프로필
보고서 3페이지
규제와 다음 단계
멀티에이전트 파이프라인 다이어그램
순서대로 늘어선 크루들
  • CrewAI
  • Brave
  • Firecrawl
  • FastAPI
  • Supabase
  • Redis
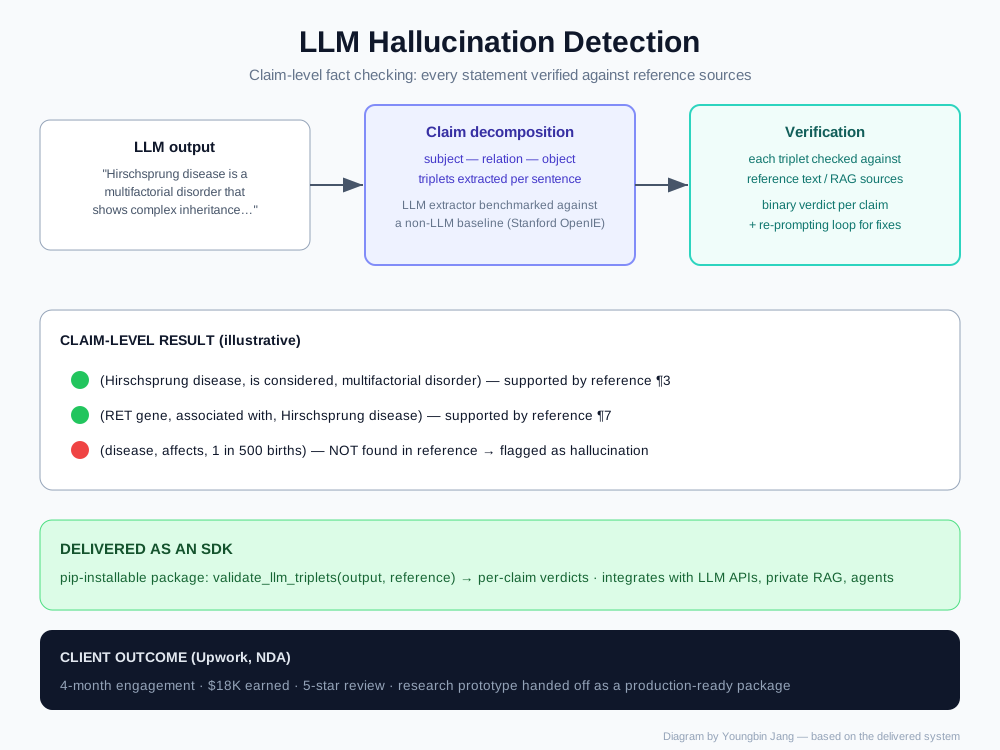
사실 검증 파이프라인 다이어그램

Upwork 고객사 (비공개)소프트웨어 회사 · Upwork 프로젝트2024–2025

AI가 지어낸 주장을 사용자보다 먼저 잡아내기

문제
답변에 참조 문서에 없는 내용이 섞였는데, 어느 문장인지 아무도 알 수 없었습니다.
만든 것
답변을 주장 단위로 쪼개 원문과 대조하고 틀린 것만 고쳐 쓰는 파이프라인을 SDK로.
  • 별 5개 평가 · $18K 프로젝트
  • pip으로 설치하는 SDK로 납품
  • 실패가 주장 단위라서, 수정도 주장 단위
사례 자세히 보기닫기

별 5개, 1만 8천 달러, 그리고 어떤 파이프라인에도 끼울 수 있는 컴포넌트.

  • 기간2024년 11월 – 2025년 3월
  • 평가별 5개, $18K
  • 납품 형태Python SDK, wheel + sdist
  • 평가 방법합성 환각 주입, 혼동 행렬 채점

필요했던 것

고객사 제품은 참조 문서로 질문에 답했는데, 답변에 문서가 말한 적 없는 내용이 섞이곤 했습니다. 어느 문장이 틀렸는지를 자동으로 알아야 했고, 답변을 버리는 대신 고쳐야 했습니다.

만든 것

답변을 주어–서술어–목적어 주장으로 바꾸고 각 주장을 참조와 대조하는 파이프라인. 너무 많이 실패하면 정확한 실패 지도를 붙여 다시 생성시켜서, 다시 쓴 답변은 틀린 것만 고치고 맞는 것은 지킵니다. 고객사가 자기 데이터로 측정할 수 있도록 기준선과 평가 키트가 딸린 설치형 SDK로 납품했습니다.

달라진 것

고객사는 별 5개 평가를 남겼습니다. 이 컴포넌트는 이식 가능합니다. 참조 텍스트가 있는 어떤 질의응답 시스템에도 끼울 수 있습니다.
기술적으로는
  • 주장별 판정: 답변의 각 트리플렛을 모든 참조 트리플렛과 한 번의 제한된 LLM 요청으로 대조. 출력은 triplet_idx:result로 강제하고 판정 지도로 병합.
  • 도전과 수정: 임계값을 넘으면 리프롬프터가 질문 + 답변 + 참조 + 트리플렛별 실패 지도로 다시 생성.
  • 교체 가능한 부품: CLI 플래그로 답변 생성기, 트리플렛 추출기, 검사기를 바꿈. 비교용 비-LLM 기준선(Stanford OpenIE, 완전 일치, 부분 일치).
  • 평가 키트: 합성 환각 주입과 혼동 행렬 채점.
  • 패키징: LLMTripletValidator 공개 API, wheel과 sdist로 빌드.
주장과 판정을 그린 지도
답변 하나의 주장들과 그 판정을 그린 지도
  • Python
  • LLM API
  • Stanford OpenIE (기준선)
에이전트 오케스트레이션 다이어그램

STIA마케팅 기술 회사 · 진행 중2025–2026

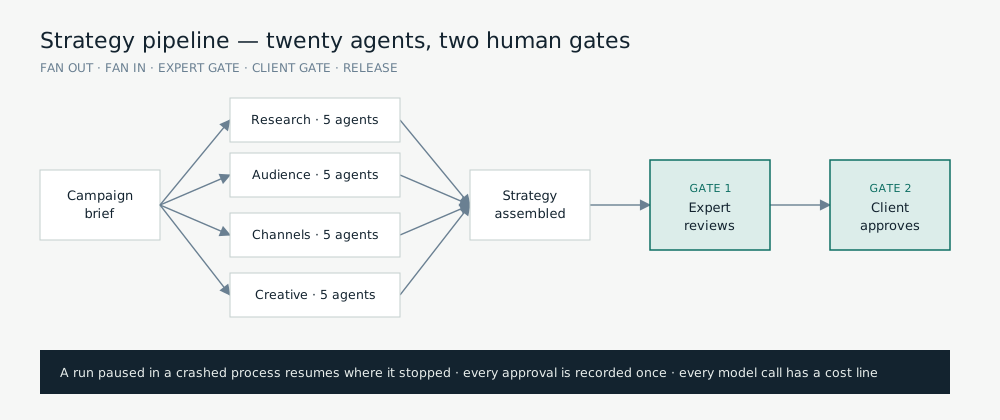
전문 에이전트 20개, 사람의 승인 2번

문제
AI가 스스로 게시하거나 연락하는 일 없이, 마케팅 전략과 아웃리치 초안을 대규모로 만들어야 했습니다.
만든 것
사람 승인 관문 2개가 있는 전문 에이전트 20개, 재개 가능한 실행, CRM과 동기화되는 리드 파이프라인.
  • 전문 서브에이전트 20개, 순차 승인 관문 2개
  • 프로세스가 죽어도 실행이 살아남아 중간부터 재개
  • 백엔드 전체에 테스트 약 1,300개
사례 자세히 보기닫기

AI는 제안할 수 있습니다. 내보내는 것은 사람만 할 수 있습니다.

  • 오케스트레이션LangGraph, 4갈래 분기 후 합류
  • 사람 관문전문가 → 고객, 관문별 권한 확인
  • 모델Anthropic, OpenAI, Gemini. 조사는 Perplexity
  • 테스트테스트 함수 약 1,300개, 147개 파일

필요했던 것

마케팅 전략을 만들고 리드 아웃리치를 대규모로 돌리는 플랫폼. AI는 절대 스스로 게시하거나 누구에게 연락하지 않고, 중단된 실행은 작업을 잃지 않아야 합니다.

만든 것

전문 에이전트 20개가 갈라졌다가 다시 모이고, 관문 2개에서 멈추는 전략 파이프라인: 전문가가 검토하고, 그다음 고객이 승인합니다. 명시적 규칙으로 리드를 선별하고(누구에게 연락할지 AI가 추측하지 않음), 정보를 보강하고, CRM과 동기화하는 리드 파이프라인. LinkedIn 아웃리치 이벤트를 듣고 답장 초안을 쓰되, 사람이 승인해야 보냅니다. 모든 실행이 결정 기록과 에이전트별 비용 항목을 남깁니다.

달라진 것

고객사는 승인이 코드로 강제되고, 실행이 재개 가능하며, 모든 모델 호출에 가격표가 붙은 시스템을 갖게 됐습니다. (이 프로젝트는 진행 중이라 성과 수치는 적지 않습니다.)

기술적으로는
  • 전략 DAG는 LangGraph StateGraph. 서브에이전트마다 자기 클래스, 자기 프롬프트 모듈, 타입이 있는 Pydantic 입출력. 라우팅이 BLOCKED를 돌려주면 조건부 엣지가 고객 관문을 건너뜀.
  • 관문은 interrupt()와 관문별 호출자 권한 확인. 모든 실행이 노드별 human | logic 출처와 변경 불가 결정 기록을 남김.
  • 내구성: Firestore 체크포인터. 죽은 프로세스에서 멈춘 실행은 클래스명 + 스레드 id로 재구성. 부분 재실행을 위한 DAG 중간 진입. LangGraph는 재개 시 노드를 다시 돌리므로 승인은 first-write-wins에 멱등. 추가 전용 장부가 모든 전달 시도를 기록. 대사 재시도는 상한을 두고 그 뒤엔 데드레터.
  • 비용 통제: 토큰 추적기(에이전트별 호출별 모델, 토큰, 비용), 사용량 쿼터 → 429, 동시 캠페인 수 상한.
  • 리드 파이프라인: 규칙 기반 3단계 선별(자동 / 사람 검토 / 제외)과 리드별 사유 기록. Apollo와 Apify로 보강. HubSpot 양방향 CRM 동기화. LinkedIn 아웃리치 웹훅은 Firestore 트랜잭션에서 참조 카운트. 답장 초안은 사람이 내보내기 전까지 검토 큐에 대기.
  • LangGraph
  • Firestore
  • FastAPI
  • Anthropic
  • OpenAI
  • Gemini
  • HubSpot API
연구 모델에서 운영 서빙까지

발표 논문응용 AI 연구2016–2025

세계 최고 성능 AI 모델 연구를 서비스에 넣기

문제
에세이 채점에 세계 최고 성능이면서 제품에 바로 넣을 수 있는 모델이 필요했습니다.
만든 것
논문의 루브릭별 채점 모델, 그리고 이후의 프롬프트 선택·RLHF·환각 탐지 연구.
  • 세계 최고 성능, arXiv 2309.02740. 계획·실행·집필 모두 직접
  • 논문의 모델이 그대로 100만 명이 쓰는 서비스로
사례 자세히 보기닫기

실험은 제품에서 돌아갈 때 끝납니다.

  • 논문Rubric-Specific Approach to Automated Essay Scoring with Augmentation Training
  • 결과발표 당시 세계 최고 성능
  • 다른 주제LLM 피드백으로 프롬프트 선택 · RLHF · 환각 탐지
  • 이전 연구판매 예측 · 질병 감시 클러스터링 · 스마트 농업

발표한 연구

Rubric-Specific Approach to Automated Essay Scoring with Augmentation Training (arXiv:2309.02740). 연구 질문부터 발표 논문까지 계획, 설계, 실행, 집필을 직접 했습니다. 자동 에세이 채점에서 세계 최고 성능을 기록했고, 논문이 설명하는 모델이 운영 환경에 들어가 약 100만 학습자의 에세이를 채점했습니다.

다른 연구

  • 과제별 모델과 LLM 피드백으로 프롬프트를 고르는 최적화 (학회 제출).
  • 보상 모델링과 사람 피드백 강화학습 (T5 보상 모델 + PPO).
  • LLM 답변의 환각 탐지 (2025). 사실 검증 SDK로 납품.
  • 이전 응용 연구: SKU 단위·농식품 판매 예측, 조류 인플루엔자 감시를 위한 철새 공간 클러스터링, 스마트 축산·토양 센서 모델링, PC 로그 데이터의 위험 신호.
고객에게 왜 중요한가

연구 습관은 납품에서 평가 세트, 심사 모델, 전후 숫자로 나타납니다. 그리고 측정 결과 아무것도 더하지 않는 기능은 끄겠다는 태도로도 나타납니다.

NDA로 이름을 밝힐 수 없는 프로젝트가 2건 더 있습니다.

고객사, 업종, 수치 없이 무엇을 만들었는지만 아래에 적었습니다. 비슷한 과제인지 판단하실 수 있게요.

비공개 프로젝트 보기

이름을 밝힐 수 없는 프로젝트.

비공개 · 2026

기억과 안전장치가 있는 대화형 에이전트

대화가 바뀌어도 사용자를 기억하고, 정해진 행동 범위를 벗어나지 않는 AI 동반자입니다. 시스템 일부가 멈춰도 실패하지 않고 할 수 있는 만큼만 답합니다.

  • LangGraph 1.0
  • 장기 기억
  • 가드레일
  • 평가 하네스
  • 트레이싱
어떻게 만들었나
  • 대화 그래프 위에 장기 기억을 얹었고, 가드레일에는 API 호출 없이 동작하는 오프라인 언어 검사가 포함됩니다.
  • 평가 하네스와 전체 트레이싱을 갖춰, 행동이 바뀌면 느낌이 아니라 숫자로 확인합니다.
  • 기능 등급별로 단계적 저하: 의존 서비스가 죽어도 에이전트는 줄어든 기능으로 계속 답합니다.
  • 타입 검사·린트·테스트(mypy, ruff, pytest)를 갖추고 문서와 함께 인도했습니다.
비공개 · 2026 · 운영 중

플랫폼 팀이 열어볼 필요 없는 AI 서비스

AI 두뇌와 고객사 플랫폼 사이에 문서화된 인터페이스 계약과 스텁 모드를 두어, 고객사 엔지니어는 안정된 인터페이스에 붙이고 AI는 그 뒤에서 계속 발전합니다.

  • FastAPI 비동기
  • 작업 큐
  • 실시간 이벤트
  • PDF/DOCX 내보내기
  • 결제
  • IaC + CI
어떻게 만들었나
  • 서비스 인터페이스 명세를 먼저 쓰고, 스텁 구현을 두어 AI가 완성되기 전에 플랫폼 팀이 개발·테스트할 수 있게 했습니다.
  • 백그라운드 작업과 실시간 업데이트가 있는 비동기 API, 문서 내보내기, 결제 연동, 오류 모니터링.
  • 첫날부터 인프라 코드화와 CI. 현재 운영 중입니다.

직접 설계하고, 직접 만들고, 숫자로 증명합니다.

  • 8년AI 연구 · 개발 경력
  • SOTA논문으로 입증한 세계 최고 성능
  • 100%소스코드 · 문서 인도
  • 위 사례를 만든 엔지니어가 직접

    영업 따로, 개발 따로가 아닙니다. 위 사례를 직접 만든 8년 차 AI 엔지니어가 첫 상담을 받고, 설계하고, 만들고, 운영합니다. 이야기 나누는 사람이 코드를 쓰는 사람입니다.

  • 소스코드 · 문서 전부 인도

    코드, 학습된 모델, 설계 문서, 평가 데이터셋, 운영 가이드까지 모두 고객의 자산이 됩니다. 외부 제품을 붙인 부분은 "연동"이라고 적지, "개발"로 숨기지 않습니다.

  • 실측 수치로 검증

    "잘 됩니다"라는 말 대신, 같은 데이터와 같은 기준으로 비교한 숫자로 성능을 보고합니다. 효과가 0으로 측정된 기능은 끄고, 그 사실을 기록합니다.

  • 출시 후 운영까지

    모니터링, 오류 대응, 재학습, 기능 추가까지 출시 이후에도 함께합니다.

자주 묻는 질문

Q.왜 2주 단위인가요?

AI 프로젝트는 직접 써보기 전까지 알 수 없는 부분이 많습니다. 2주마다 작동하는 결과를 확인하면 방향이 틀렸을 때 빨리 바로잡을 수 있고, 그만큼 비용 낭비가 줄어듭니다.

Q.소스코드와 산출물은 받을 수 있나요?

네. 소스코드, 학습된 모델, 데이터 처리 스크립트, 설계·운영 문서를 모두 넘겨드리고, 인도 범위는 계약서에 적어 둡니다.

Q.대금은 어떻게 내나요?

마일스톤별 고정 금액입니다. 마일스톤마다 직접 해보실 수 있는 검수 기준이 글로 적혀 있고, 대금은 날짜가 아니라 검수 뒤에 냅니다. Upwork를 통하거나 투윅스와 직접 계약하실 수 있습니다.

Q.AI 결과물의 품질은 어떻게 확인하나요?

실제 데이터로 측정한 숫자로 확인합니다. 예를 들어 음성인식은 같은 통화 2,354문장을 제 모델과 상용 서비스에 나란히 돌려 틀린 글자 수를 비교해 보고했습니다.

Q.데이터가 정리되어 있지 않아도 되나요?

괜찮습니다. 흩어진 문서, 녹취 파일, 엑셀처럼 정리되지 않은 데이터를 쓸 수 있는 형태로 만드는 일부터 함께합니다.

Q.프리랜서인가요, 회사인가요?

둘 다입니다. 제 회사 투윅스(TwoWeeks)를 통해서도, Upwork를 통해서도 일합니다. 어느 쪽이든 저와 직접 일하시게 됩니다.

2주 뒤, 작동하는 결과로 보여드리겠습니다.

해결하고 싶은 문제를 Upwork 메시지로 보내 주세요. 첫 상담이 끝나면 문제가 한 문장으로 정리되고, AI가 맞는 도구인지 아닌지, 아니라면 무엇이 맞는지 답을 가져가시게 됩니다.

국내 기업이신가요? 같은 일을 제 회사 투윅스를 통해서도 맡고 있습니다. twoweeks-acu.pages.dev ↗

이렇게 적어 주시면 더 빠르게 답변드립니다
  1. 회사 · 서비스 소개
  2. 해결하고 싶은 문제
  3. 가지고 계신 데이터
  4. 희망 일정 · 예산